01
信息散落
工单、CRM、合同、SOP 与历史案例彼此割裂,客服需要反复切换查找。
 CasePilot
查看产品
面向企业客户投诉与退款场景,连接工单、客户记录、合同条款与服务知识,让 AI 给出有证据的判断,由人确认边界并推动执行。
围绕真实业务责任设计
问题不在于客服回复得不够快,而在于信息、判断与执行分散在多个系统和角色之间。
工单、CRM、合同、SOP 与历史案例彼此割裂,客服需要反复切换查找。
风险等级和补偿尺度缺少统一依据,关键结论无法被复核与复用。
方案确认后仍要手工建任务、催审批,结果也没有回到下一次决策。
用风险、SLA、客户等级和投诉趋势形成统一优先级。
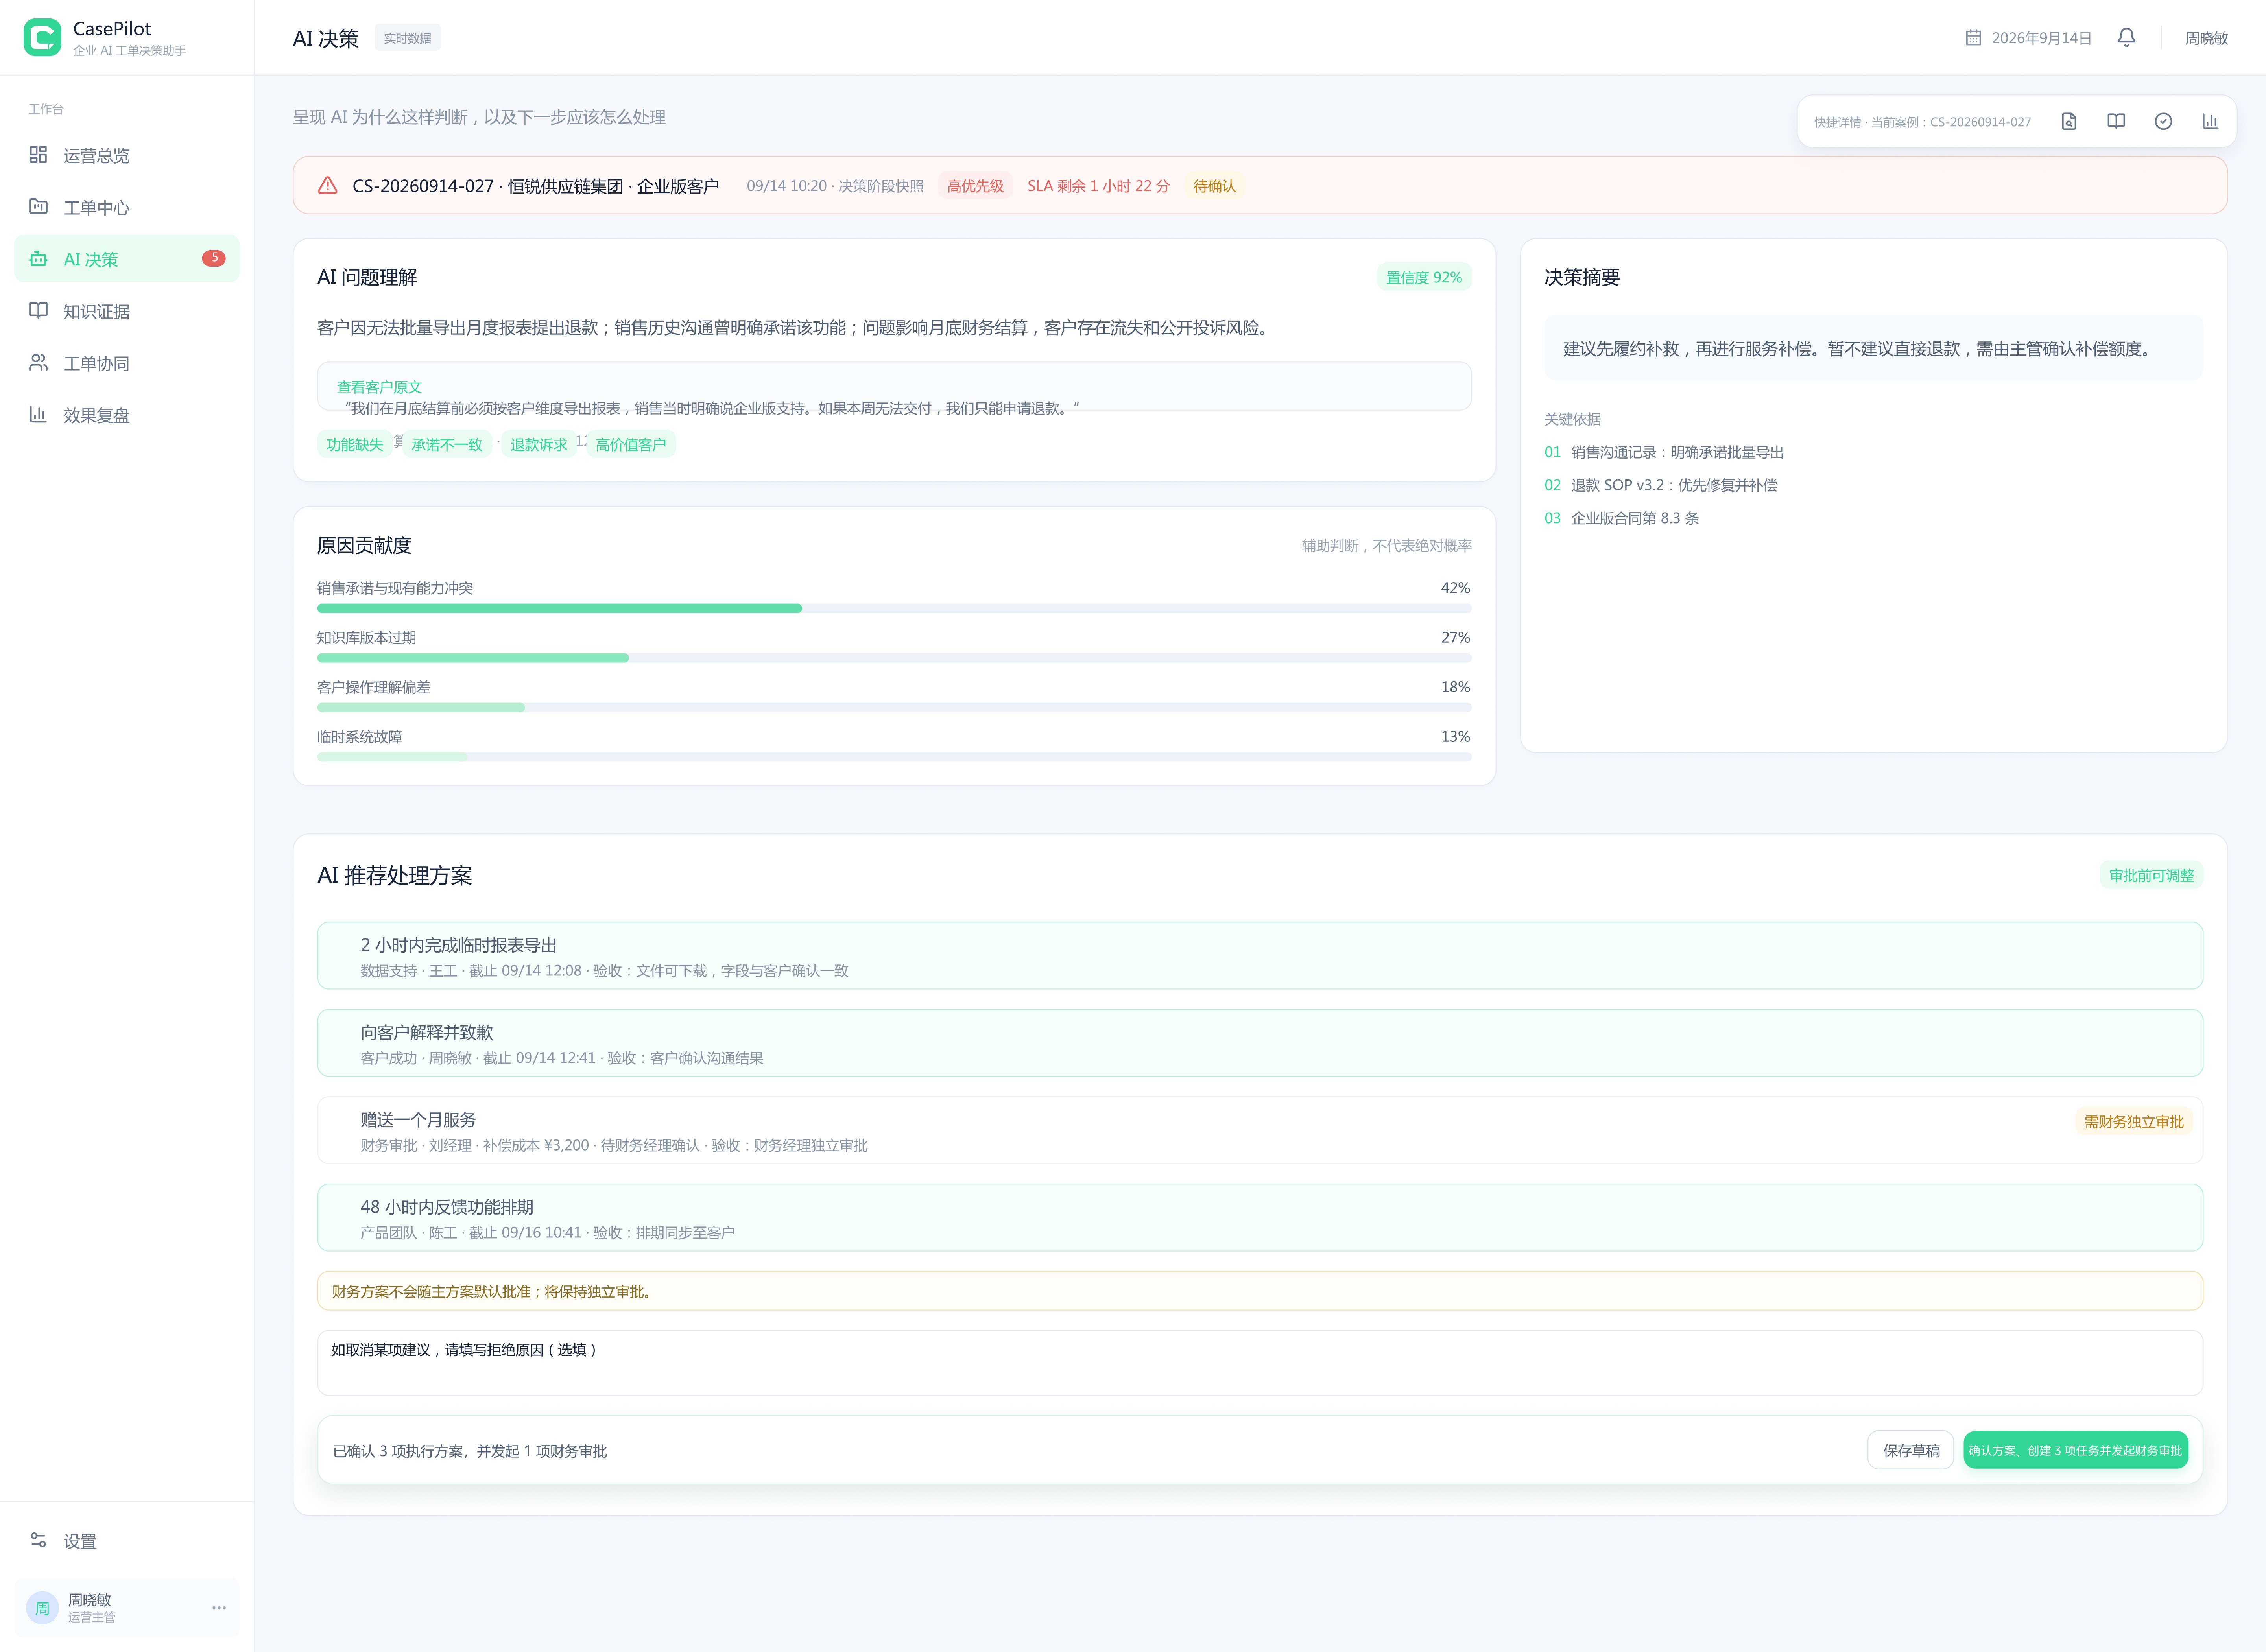 需求洞察 / AI 问题理解
高风险工单不是“说什么”的问题,而是“依据什么做决定、谁承担责任、结果如何验证”的问题。
读取诉求、客户等级、历史承诺与潜在风险。
关联 SOP、合同规则、销售记录与相似工单。
输出原因、建议动作、责任人和验收标准。
财务补偿和例外方案必须由对应角色审批。
围绕同一张退款工单,把识别、推理、核验、审批、执行与复盘串成一条可追踪路径。
从运营判断到知识回流,每个页面只承担一个清晰的业务职责。
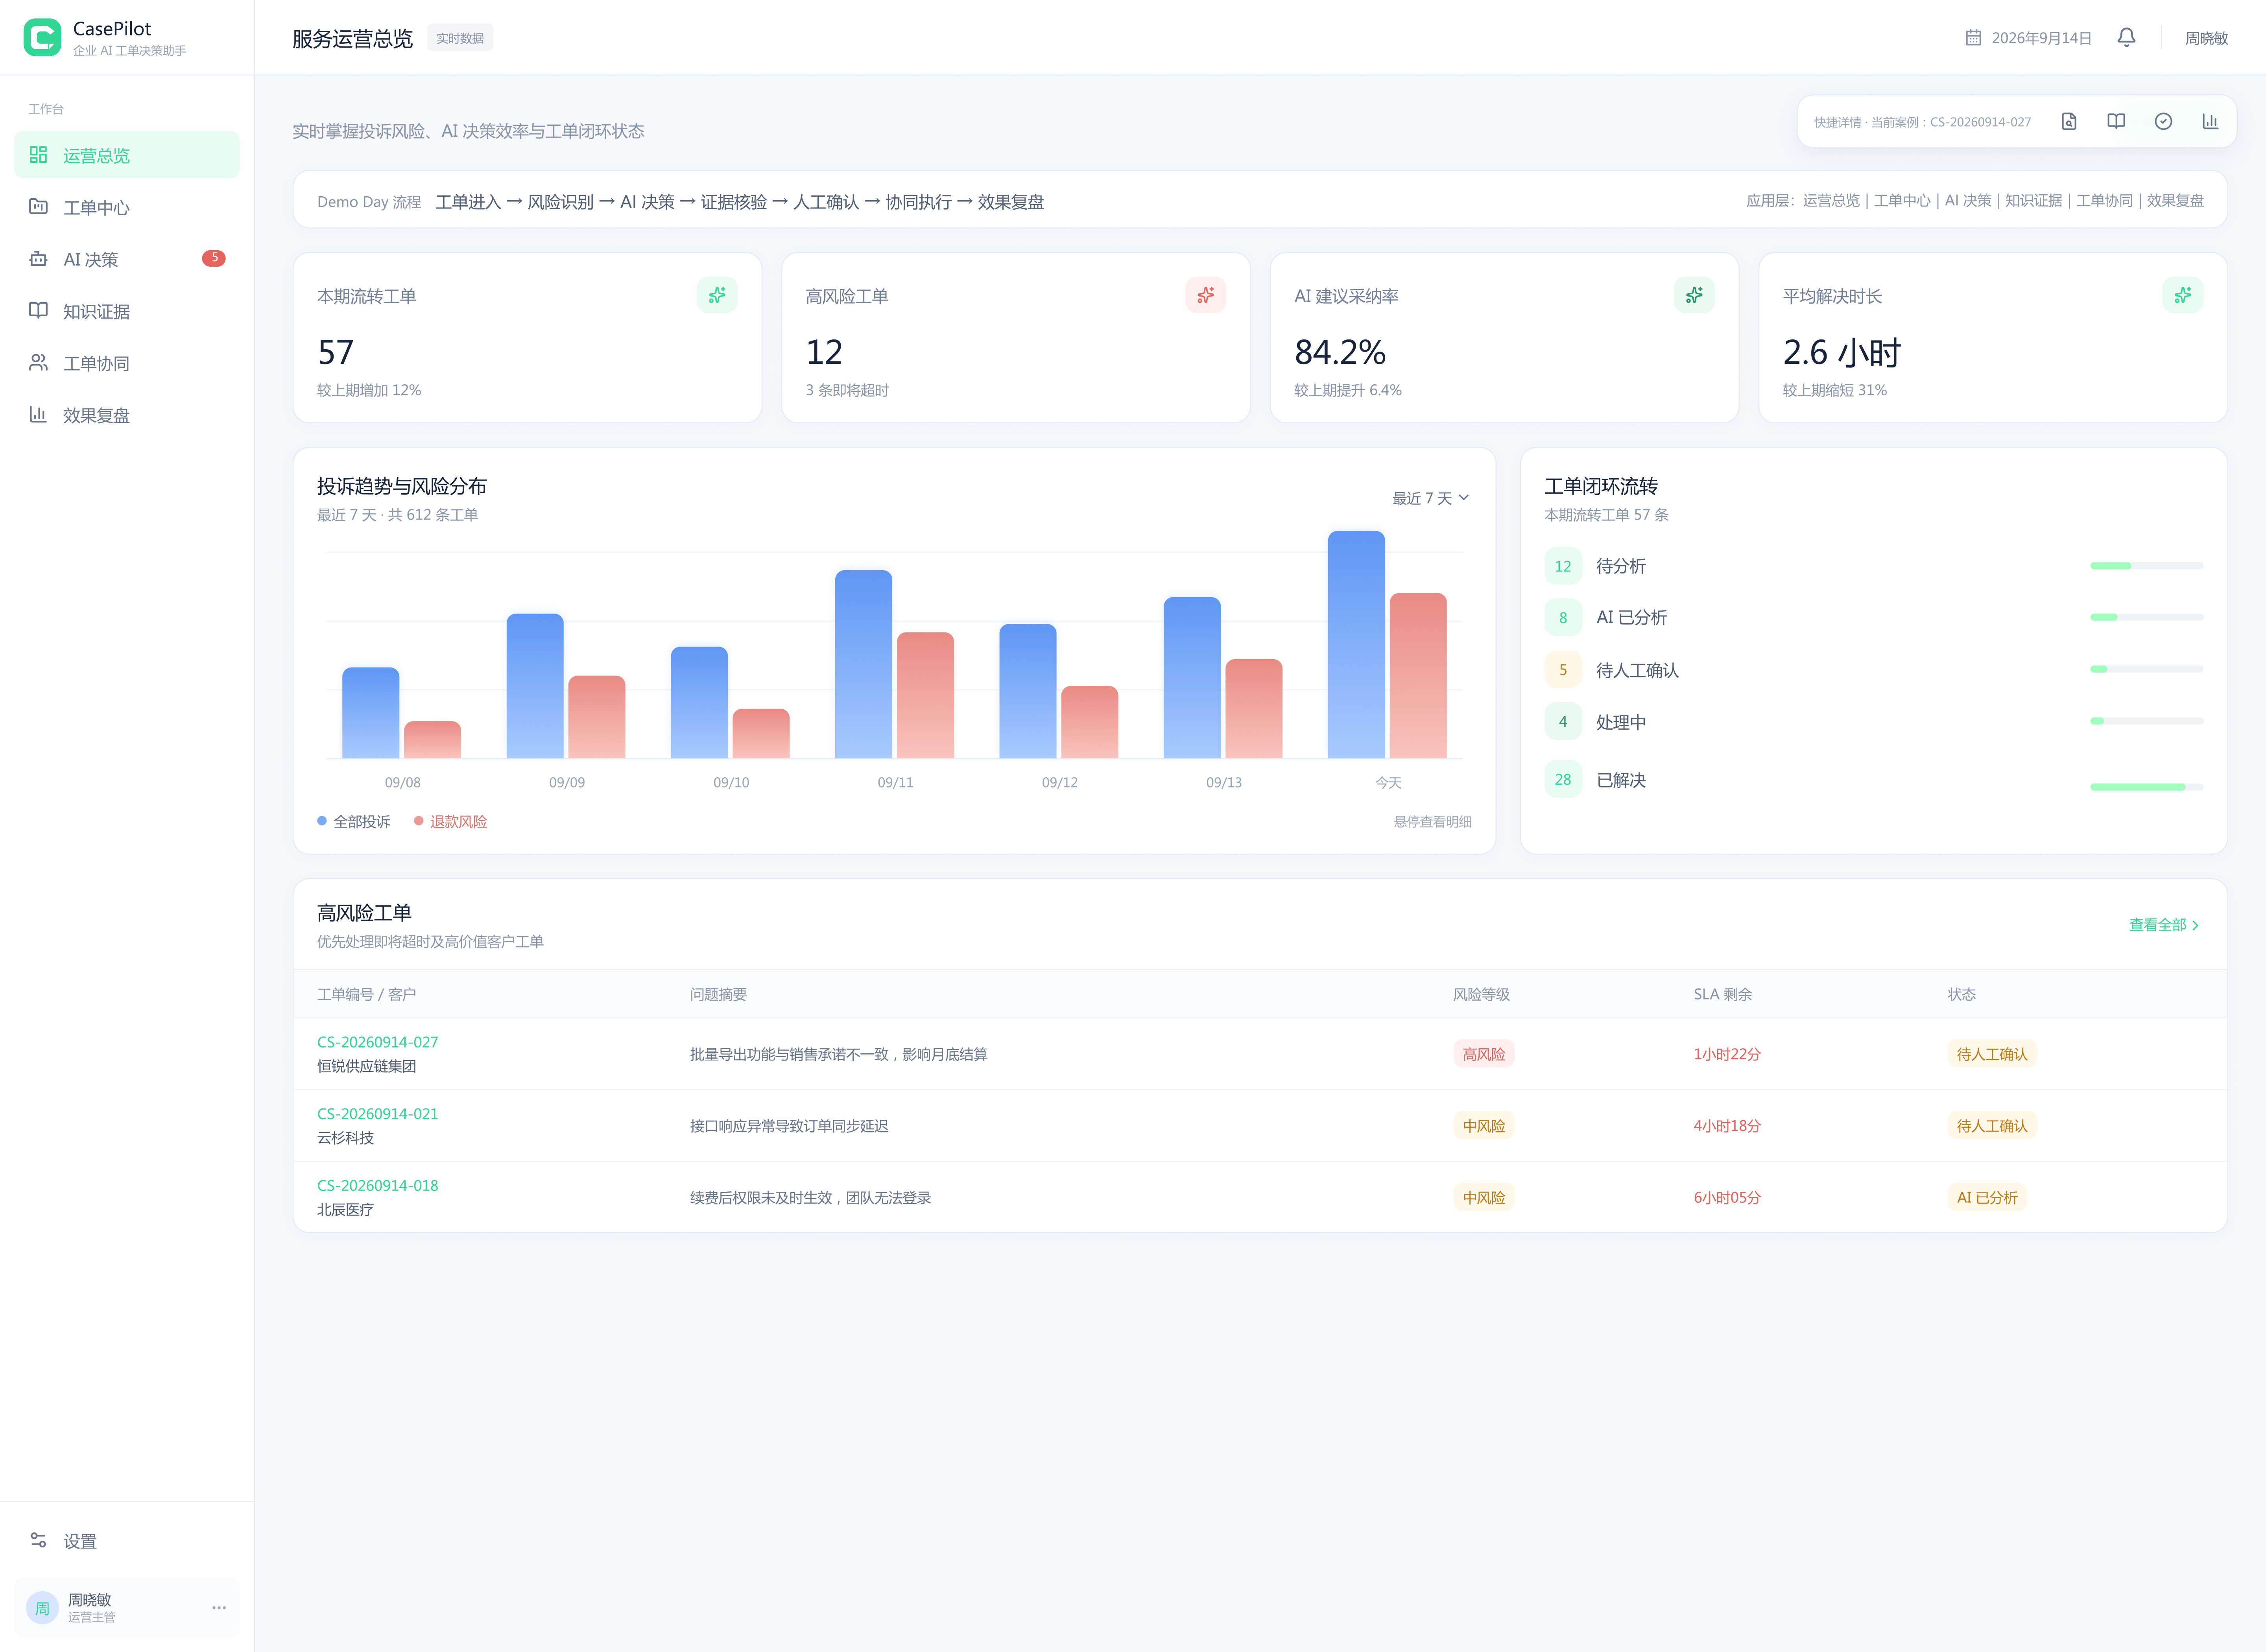
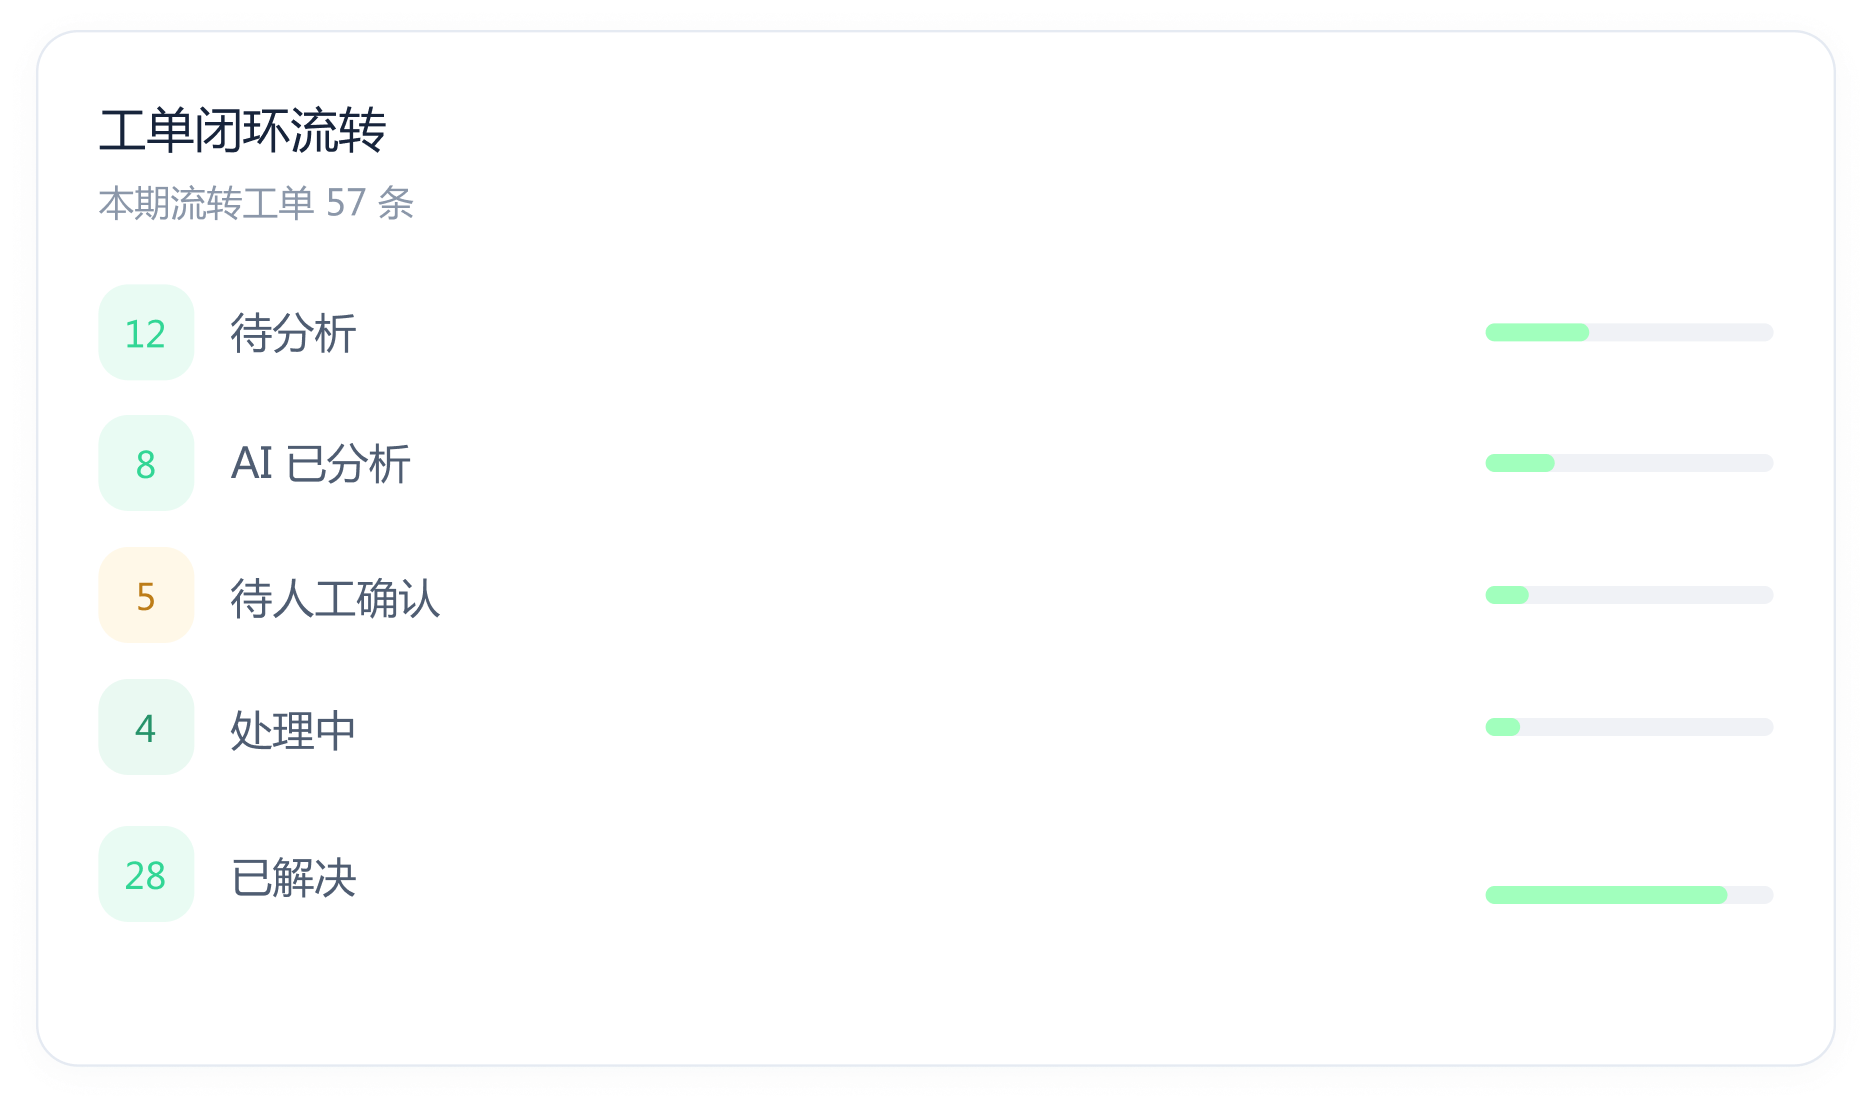
演示数据 / 原型验证目标,不代表生产环境真实结果聚合投诉趋势、风险等级、SLA 与闭环状态,让运营主管先决定今天处理什么。
用户可围绕当前工单继续追问。每次回答都绑定原始证据、版本与适用范围;追问只用于解释和方案推演,不会绕过审批直接执行。
现有证据表明,客户核心诉求是获得月度报表,而不是终止服务。优先补交报表并提供服务补偿,能更低成本地修复履约关系;退款额度仍需主管确认。
若报表无法补交、客户明确终止服务,或合同条款存在冲突,停止自动建议并转人工复核。
点击每个层级,查看输入、处理、输出与异常回退;模型负责非确定性判断,规则和人工守住执行边界。
统一工单、客户、合同和历史协同记录,先解决“信息是否完整、身份是否一致”。
工单原文、客户等级、合同编号、销售沟通和历史处理记录。
字段标准化、实体匹配、数据权限检查和缺失信息识别。
结构化工单上下文、风险信号和待补充字段。
客户身份不一致、关键字段缺失或越权访问时,要求人工补充并记录审计日志。
同时观察服务质量、协同效率与 AI 建议采纳情况,不用单一模型准确率替代产品价值。
对比周期:上线前 30 天 vs 本期 30 天 · 有效工单样本 1,842 条
口径说明:退款申请撤回率按撤回退款申请工单数 ÷ 退款申请工单数计算;平均解决时长从首次受理至验收完成;SLA 达成率按约定时限内完成的有效工单计算。
演示数据 / 原型验证目标,不代表生产环境真实结果
每一轮迭代都在回答:AI 能否更接近真实业务责任,而不是只产出更多文本。
以下为原型阶段的验证路径、指标设计与阶段判断,不代表生产环境实测结果。
模型能从工单文本识别诉求、影响和高风险信号。
意图 F1、高风险召回率、P95 响应时间。
生成更快,但没有证据的结论难以被业务采纳。
接入 RAG,让判断可追溯。
混合召回、重排与版本过滤可提升证据覆盖。
Recall@5、MRR、引用准确率、检索 P95。
结论可以回到原文;过期与冲突知识仍需拦截。
增加时效校验、拒答与人工复核。
固定业务 Skill 能让建议更稳定、更符合审批边界。
事实一致性、规则符合率、建议采纳率、风险误放行率。
高风险动作必须保留人工确认和独立审批。
将建议拆为可执行任务,并记录修改原因。
标准工具接口能把决策可靠地推入审批和执行系统。
工具调用成功率、任务创建成功率、端到端 P95、回退率。
接口超时和重复调用要求幂等、重试、回滚与审计。
先影子运行,再灰度开放低风险动作。
执行结果与人工修改原因能持续校正知识和评测集。
SLA、解决时长、返工率、人工接管率、样本增长率。
模型指标只能作为过程信号,最终仍需回到业务结果。
离线评测通过后,按风险等级逐步扩大流量。